La generación aumentada por recuperación (RAG) es una arquitectura que se usa para optimizar el rendimiento de un modelo de inteligencia artificial, conectándolo con bases de conocimiento externas.
Entender qué es RAG y cómo funciona es fundamental para ayudar a los modelos de lenguaje de gran tamaño (como los de IA generativa) a ofrecer respuestas más relevantes y de mayor calidad.
Para quienes se dedican al campo de la programación, especializarse en esta área puede suponer un impulso profesional. Con el Curso en IA y Data Science de UNIR podrás profundizar en qué es la RAG y dominar su funcionamiento y aplicaciones.
¿Qué es RAG (Generación Aumentada por Recuperación)?
RAG son las siglas en inglés de Retrieval Augmented Generation o generación aumentada por recuperación. Google Cloud define qué es RAG como “un framework de inteligencia artificial que combina las ventajas de los sistemas tradicionales de recuperación de información (como la búsqueda y las bases de datos) con las capacidades de los modelos generativos de lenguaje extenso (LLM)”.
Al combinar tus datos y el conocimiento del mundo con las habilidades lingüísticas de los LLMs, la generación fundamentada es más precisa, actualizada y relevante para tus necesidades específicas.
Fuente: Google Cloud
Por eso, los modelos de lenguaje de gran tamaño son una tecnología clave de la inteligencia artificial en la que se basan los chatbots inteligentes y otras aplicaciones de procesamiento de lenguaje natural (NLP).
¿Cómo funciona RAG?
Según explica IBM, la RAG permite que los modelos de IA generativa accedan a bases de conocimiento externas adicionales. Al integrar esa información relevante en el proceso de generación, los chatbots y otras herramientas de procesamiento del lenguaje natural (PLN) pueden crear contenidos específicos de dominio más precisos sin necesidad de formación adicional.
Fuente: IBM
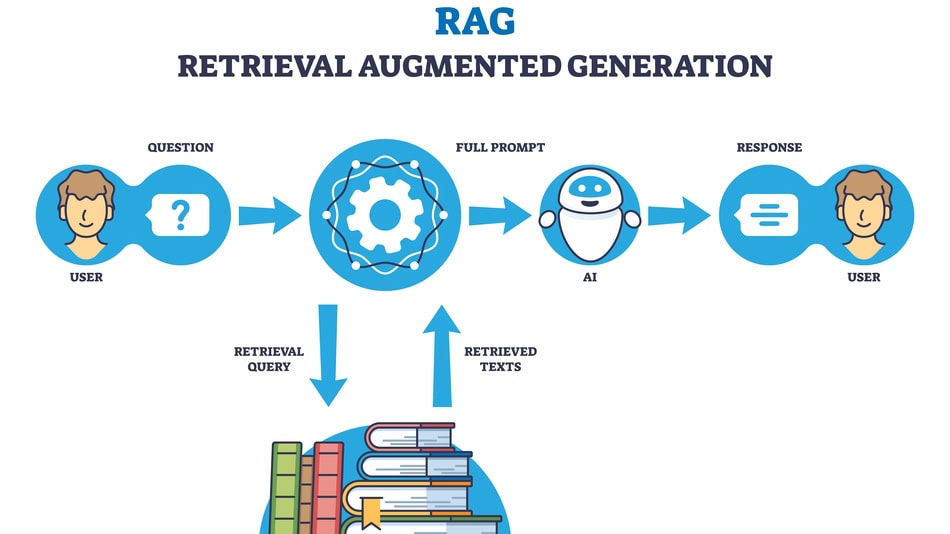
Para saber mejor qué es la RAG, es importante tener claro que las RAG siguen una serie de pasos para mejorar los resultados de la IA generativa:
- Utilizan potentes algoritmos de búsqueda para hacer consultas a datos externos (páginas web, bases de conocimiento, bases de datos).
- Tras obtener la información, esta se somete a un procesamiento, que incluye la tokenización, la raíz y la eliminación de las palabras irrelevantes.
- La información obtenida se incorpora al LLM entrenado previamente, mejorando el contexto del LLM y proporcionando una comprensión más completa del tema.
- De esta manera, los LLMs generan respuestas más precisas, informativas y atractivas.
Beneficios de RAG
Amazon Web Services recoge los diversos beneficios que ofrece la tecnología RAG:
- Es más rentable para introducir datos nuevos en el LLM que tener que volver a entrenar a los modelos fundacionales (FM).
- Permite al LLM presentar información precisa con la atribución de la fuente, así los usuarios pueden buscar los documentos de origen si necesitan más detalles o aclaraciones.
- Los desarrolladores tienen más control y pueden probar y mejorar sus aplicaciones de chat de forma más eficiente.
Fuente: AWS
Además, podemos añadir otras ventajas de la tecnología RAG sobre los métodos tradicionales de generación aumentada:
- Proporciona información actualizada a los LLMs, que se limitan a sus datos previamente entrenados y, por tanto, puede dar lugar a respuestas obsoletas e inexactas.
- El modelo basa sus respuestas en documentos reales para evitar la invención de datos.
- Proporciona datos específicos de un dominio o empresa sin alterar el núcleo del sistema, lo que aporta mayor contexto.
- Permite actualizar la información de forma instantánea, es decir, en tiempo real.
- Facilita la gestión de permisos para que el sistema solo acceda a los datos permitidos, ofreciendo mayor seguridad.
Todo ello aumenta la confianza de los usuarios y permite más aplicaciones del modelo.
RAG vs. Fine-tuning
RAG y Fine-tuning son dos métodos clave para personalizar modelos de lenguaje. Su objetivo es el mismo: mejorar el rendimiento de un modelo para maximizar el valor para la empresa que lo utiliza. Ambos funcionan adaptando el LLM a los casos de uso específicos pero las metodologías en las que se basan son muy distintas.
Su principal diferencia está en que el modelo RAG busca y añade información externa al contexto de la consulta, mientras Fine-tuning reentrena y modifica los parámetros internos del modelo.
Cómo implementar un sistema RAG
La implementación de un sistema RAG ofrece un escalado más rentable de la IA. Por eso resulta muy interesante para las organizaciones. ¿Cómo implementarlo?
- Definir el objetivo y las fuentes: reunir documentos fiables, actualizados y relacionados con las preguntas previstas.
- Preparar los datos: limpiar los archivos, dividirlos en fragmentos y añadir metadatos como título, fecha, autor o permisos.
- Crear el índice: transformar cada fragmento en un embedding y guardarlo en una base vectorial.
- Recuperar el contexto: convertir la consulta en otro embedding y localizar los fragmentos más relevantes (se puede combinar la búsqueda semántica con palabras clave).
- Generar la respuesta: entregar al modelo la pregunta y la información recuperada, indicándole que use solamente esas evidencias, que cite las fuentes y que admita cuándo faltan datos.
- Evaluar y mejorar: revisar la relevancia, la fidelidad, las citas, la seguridad y el tiempo de respuesta.
Casos de uso de RAG
Existen diversos ejemplos de uso en nuestra vida cotidiana que permiten comprender mejor qué es una RAG y cómo y dónde se aplica en la actualidad. Algunos casos de uso son:
- Chatbots para atención al cliente que proporcionan datos sobre políticas actualizadas de devolución y proporcionan respuestas más específicas y precisas.
- Asistentes virtuales de diagnóstico médico que recuperan información de bases de datos sanitarias y proporcionan un diagnóstico más preciso y actualizado.
- Asistentes periodísticos que recuperan datos concretos de estudios y artículos recientes para ofrecer una base más sólida para escribir un artículo.
Incluso en el uso de herramientas de IA generativa como ChatGPT o Gemini, los usuarios pueden comprobar que las respuestas son cada vez más completas y precisas. Esto es gracias al uso de la tecnología RAG.
BIBLIOGRAFÍA:
Belcic, I. (2024, octubre 21). ¿Qué es el RAG (generación aumentada por recuperación)? Ibm.com. https://www.ibm.com/es-es/think/topics/retrieval-augmented-generation
Belcic, I., & Stryker, C. (2025, noviembre 28). RAG en comparación con fine-tuning. Ibm.com. https://www.ibm.com/es-es/think/topics/rag-vs-fine-tuning
¿Qué es la generación aumentada de recuperación (RAG)? (s/f). Google Cloud. Recuperado el 29 de julio de 2026, de https://cloud.google.com/use-cases/retrieval-augmented-generation?hl=es
(S/f-a). Amazon.com. Recuperado el 29 de julio de 2026, de https://aws.amazon.com/es/what-is/retrieval-augmented-generation/
(S/f-b). Gob.es. Recuperado el 29 de julio de 2026, de https://datos.gob.es/es/blog/tecnicas-rag-como-funcionan-y-ejemplos-de-casos-de-uso